Dépendance à une API de LLM : le test de la semaine
La plupart des fonctionnalités IA dans les logiciels métier reposent sur une seule API de LLM, souvent celle d’OpenAI. Ce n’est pas un problème en soi : ces modèles sont bons, et leur prix au token a plutôt baissé ces dernières années.
Le problème apparaît le jour où vous devez changer, et où vous découvrez que vous ne savez pas le faire. Un modèle déprécié, une facture qui dérive, un client qui demande où vont ses données : la question n’est pas de savoir si ça arrivera, mais combien de temps il vous faudra pour réagir.
Ce qu’est vraiment le lock-in
Vous êtes verrouillé quand le coût de changement de fournisseur dépasse le gain que vous en attendez. Ce n’est pas une question de qualité du fournisseur. C’est une question de liberté de manœuvre.
Avec une API de LLM, ce coût est trompeur. Changer d’endpoint prend une heure : la plupart des moteurs d’inférence exposent aujourd’hui une API compatible OpenAI. Ce qui coûte cher, ce sont les prompts réglés pour un modèle précis, les comportements dont votre produit dépend sans le savoir, et l’absence de moyen de mesurer ce qui change.
Quatre façons de dépendre d’une API
Le coût. Le risque n’est pas tant la hausse du prix au token que son imprévisibilité. Tokens de raisonnement, tarification du cache, contexte long : la structure tarifaire évolue, et votre coût par requête avec. Vos contrats clients, eux, sont fixes.
Le modèle. Les fournisseurs proposent des versions datées et préviennent avant de les retirer. Mais ils les retirent. À une date que vous ne choisissez pas, vous migrez, et le ton, les refus, la précision ou le format de sortie de votre fonctionnalité changent.
Les données. Chaque appel transmet vos données. “Zero data retention” veut dire qu’elles ne sont pas conservées, pas qu’elles ne sortent pas. Et un hébergement en région européenne ne règle pas tout : un fournisseur américain reste soumis au Cloud Act, qui permet aux autorités américaines d’exiger des données où qu’elles soient stockées. Pour des données RH, juridiques ou de santé, c’est souvent rédhibitoire.
La disponibilité. Rate limits, incidents, quotas, évolution des conditions d’utilisation : le SLA de votre fonctionnalité est borné par celui de votre fournisseur.
Aucun de ces risques n’est un bug. Ils viennent tous de la même décision : avoir laissé un modèle précis devenir une hypothèse de votre produit.
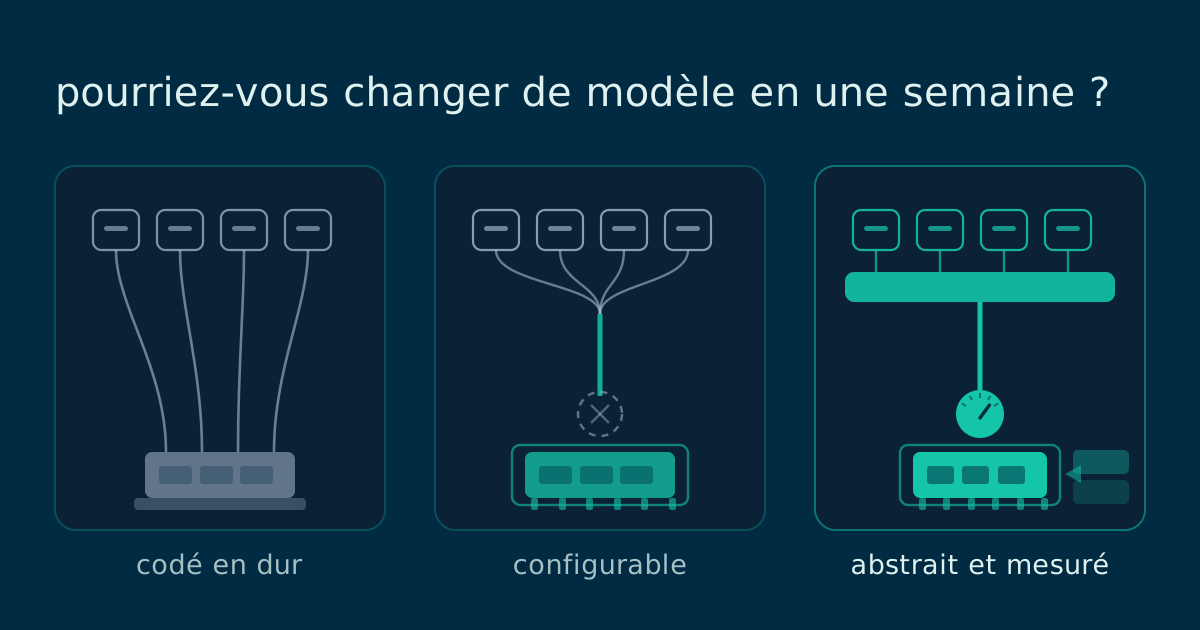
Le test : pourriez-vous changer de modèle en une semaine ?
Posez la question à votre équipe : si votre modèle disparaissait demain, combien de temps pour basculer, et comment sauriez-vous si la qualité a baissé ? La réponse vous place sur l’un de ces trois niveaux.
| Niveau | Où est le modèle | Changer, c’est… |
|---|---|---|
1Codé en dur | Où est le modèleClé, endpoint et nom de modèle dispersés dans vos services | Changer, c’est…Un chantier de refactoring |
2Configurable | Où est le modèleUn paramètre dans un fichier de configuration | Changer, c’est…Un changement rapide, mais une régression non mesurée |
3Abstrait et mesuré | Où est le modèleDerrière une interface interne, avec un jeu d’évaluation | Changer, c’est…Une bascule mesurée en quelques jours |
Le niveau 2 est le plus trompeur. Il donne l’illusion de la liberté : la ligne de config change en dix secondes, mais personne ne sait ce qui a cassé.
Ce qu’on a appris en faisant tourner nos propres modèles
Chez Agora, nous servons des modèles open weight sur notre propre infrastructure, en France, et nous en changeons à mesure que de meilleurs sortent. Changer de modèle n’est pas un incident pour nous, c’est notre routine.
La leçon : changer d’endpoint ne prend rien. Ce qui prend du temps, c’est de savoir si le nouveau modèle fait aussi bien sur vos cas, et pas sur un benchmark public.
Trois leviers pour garder la main
1. Une interface, pas un modèle. Vos services appellent “générer”, “extraire”, “transcrire”, jamais un nom de modèle. Le choix du modèle, les prompts et les paramètres vivent derrière cette interface. Avec le standard de fait des API compatibles OpenAI, cette couche coûte peu à construire.
2. Un jeu d’évaluation à vous. Quelques centaines de cas tirés de votre usage réel, avec la réponse attendue. C’est lui qui transforme une migration subie en décision mesurée. Un modèle que vous ne mesurez pas est un modèle que vous ne pouvez pas changer.
3. Une option locale pour les données sensibles. Pour les données qui ne doivent pas sortir, la réponse n’est pas un meilleur DPA : c’est de ne pas les transmettre. Un modèle open weight servi sur une infrastructure que vous ou votre prestataire européen contrôlez règle la question à la racine.
Une fois ces trois leviers en place, choisir le meilleur modèle par tâche devient simple : un petit modèle rapide pour l’extraction, un plus gros pour la rédaction. Et prévoir un modèle de repli quand le principal tombe devient une ligne de configuration, mesurée.
Pour un éditeur de logiciel, c’est un sujet commercial
Vos clients vous posent déjà la question : où vont nos données, qui y a accès, sous quelle juridiction ? “Chez un fournisseur américain, mais en région européenne” ne suffit plus dans les appels d’offres publics, la santé ou les RH.
Votre marge dépend d’un prix que vous ne négociez pas. Et votre roadmap dépend du calendrier de dépréciation de quelqu’un d’autre.
Une architecture où le modèle est interchangeable et mesuré répond aux trois. Ce n’est pas un raffinement technique : c’est un argument de vente.
À retenir
- Le lock-in, c’est quand changer coûte plus que ce que ça rapporte. Avec un LLM, le coût n’est pas dans l’endpoint, il est dans la mesure.
- Le test : si votre modèle disparaissait demain, pourriez-vous basculer en une semaine, et prouver que la qualité tient ?
- Trois leviers : une interface interne, un jeu d’évaluation, une option locale pour les données sensibles.
C'est l'architecture que nous avons construite pour nos propres produits, et celle que la plateforme Agora apporte aux éditeurs qui intègrent l'IA.
Intégrez l'IA dans votre logiciel avec Agora Software.
Parlons-en