Transcription IA et reconnaissance vocale, intégrées à votre logiciel
Vos utilisateurs parlent à votre logiciel, dans leur langue, sur le terrain comme au bureau. Plus qu'une transcription : des workflows agentiques qui transforment la parole en action.
Ce que ça fait
La reconnaissance vocale fait de la voix une interface naturelle de votre logiciel. Vos utilisateurs dictent, commandent, interrogent, en temps réel, dans leur langue.
Transcription en temps réel
Transcription en streaming basse latence. L'utilisateur voit le texte apparaître au fil de la parole. L'agent reçoit le texte et peut déclencher des actions immédiatement.
Transcription automatique des enregistrements
Pour les enregistrements, réunions ou documents audio, la transcription de l'audio en texte se fait en batch ou en asynchrone, quand la latence n'est pas critique.
Bien plus qu'une transcription automatique
Une alternative souveraine à l'API Whisper, hébergée en France. La plateforme est multi-modèle ASR : nous évaluons en continu les modèles de speech-to-text et retenons, pour chaque langue et chaque usage, celui qui donne le meilleur résultat.
Une API de transcription vous rend du texte. Agora vous rend un résultat.
Étape 1
Transcription
Multi-modèle ASR : le meilleur modèle selon la langue et l'usage.
Étape 2
Contexte
Votre vocabulaire métier, vos noms propres, vos codes produit.
Étape 3
Enrichissement
Un LLM corrige, structure et extrait les informations utiles.
Étape 4
Action
Votre logiciel remplit la fiche, produit le compte rendu, déclenche la suite.
Une API de transcription s'arrête à la première étape.
Vous n'êtes lié à aucun modèle ni à aucun fournisseur : quand un modèle plus performant sort, votre logiciel en profite sans changer d'intégration.
Hébergé en France • RGPD natif • Aucun fournisseur externe • Aucune limite de durée • Audio jamais stocké
Workflow agentique autour de la voix
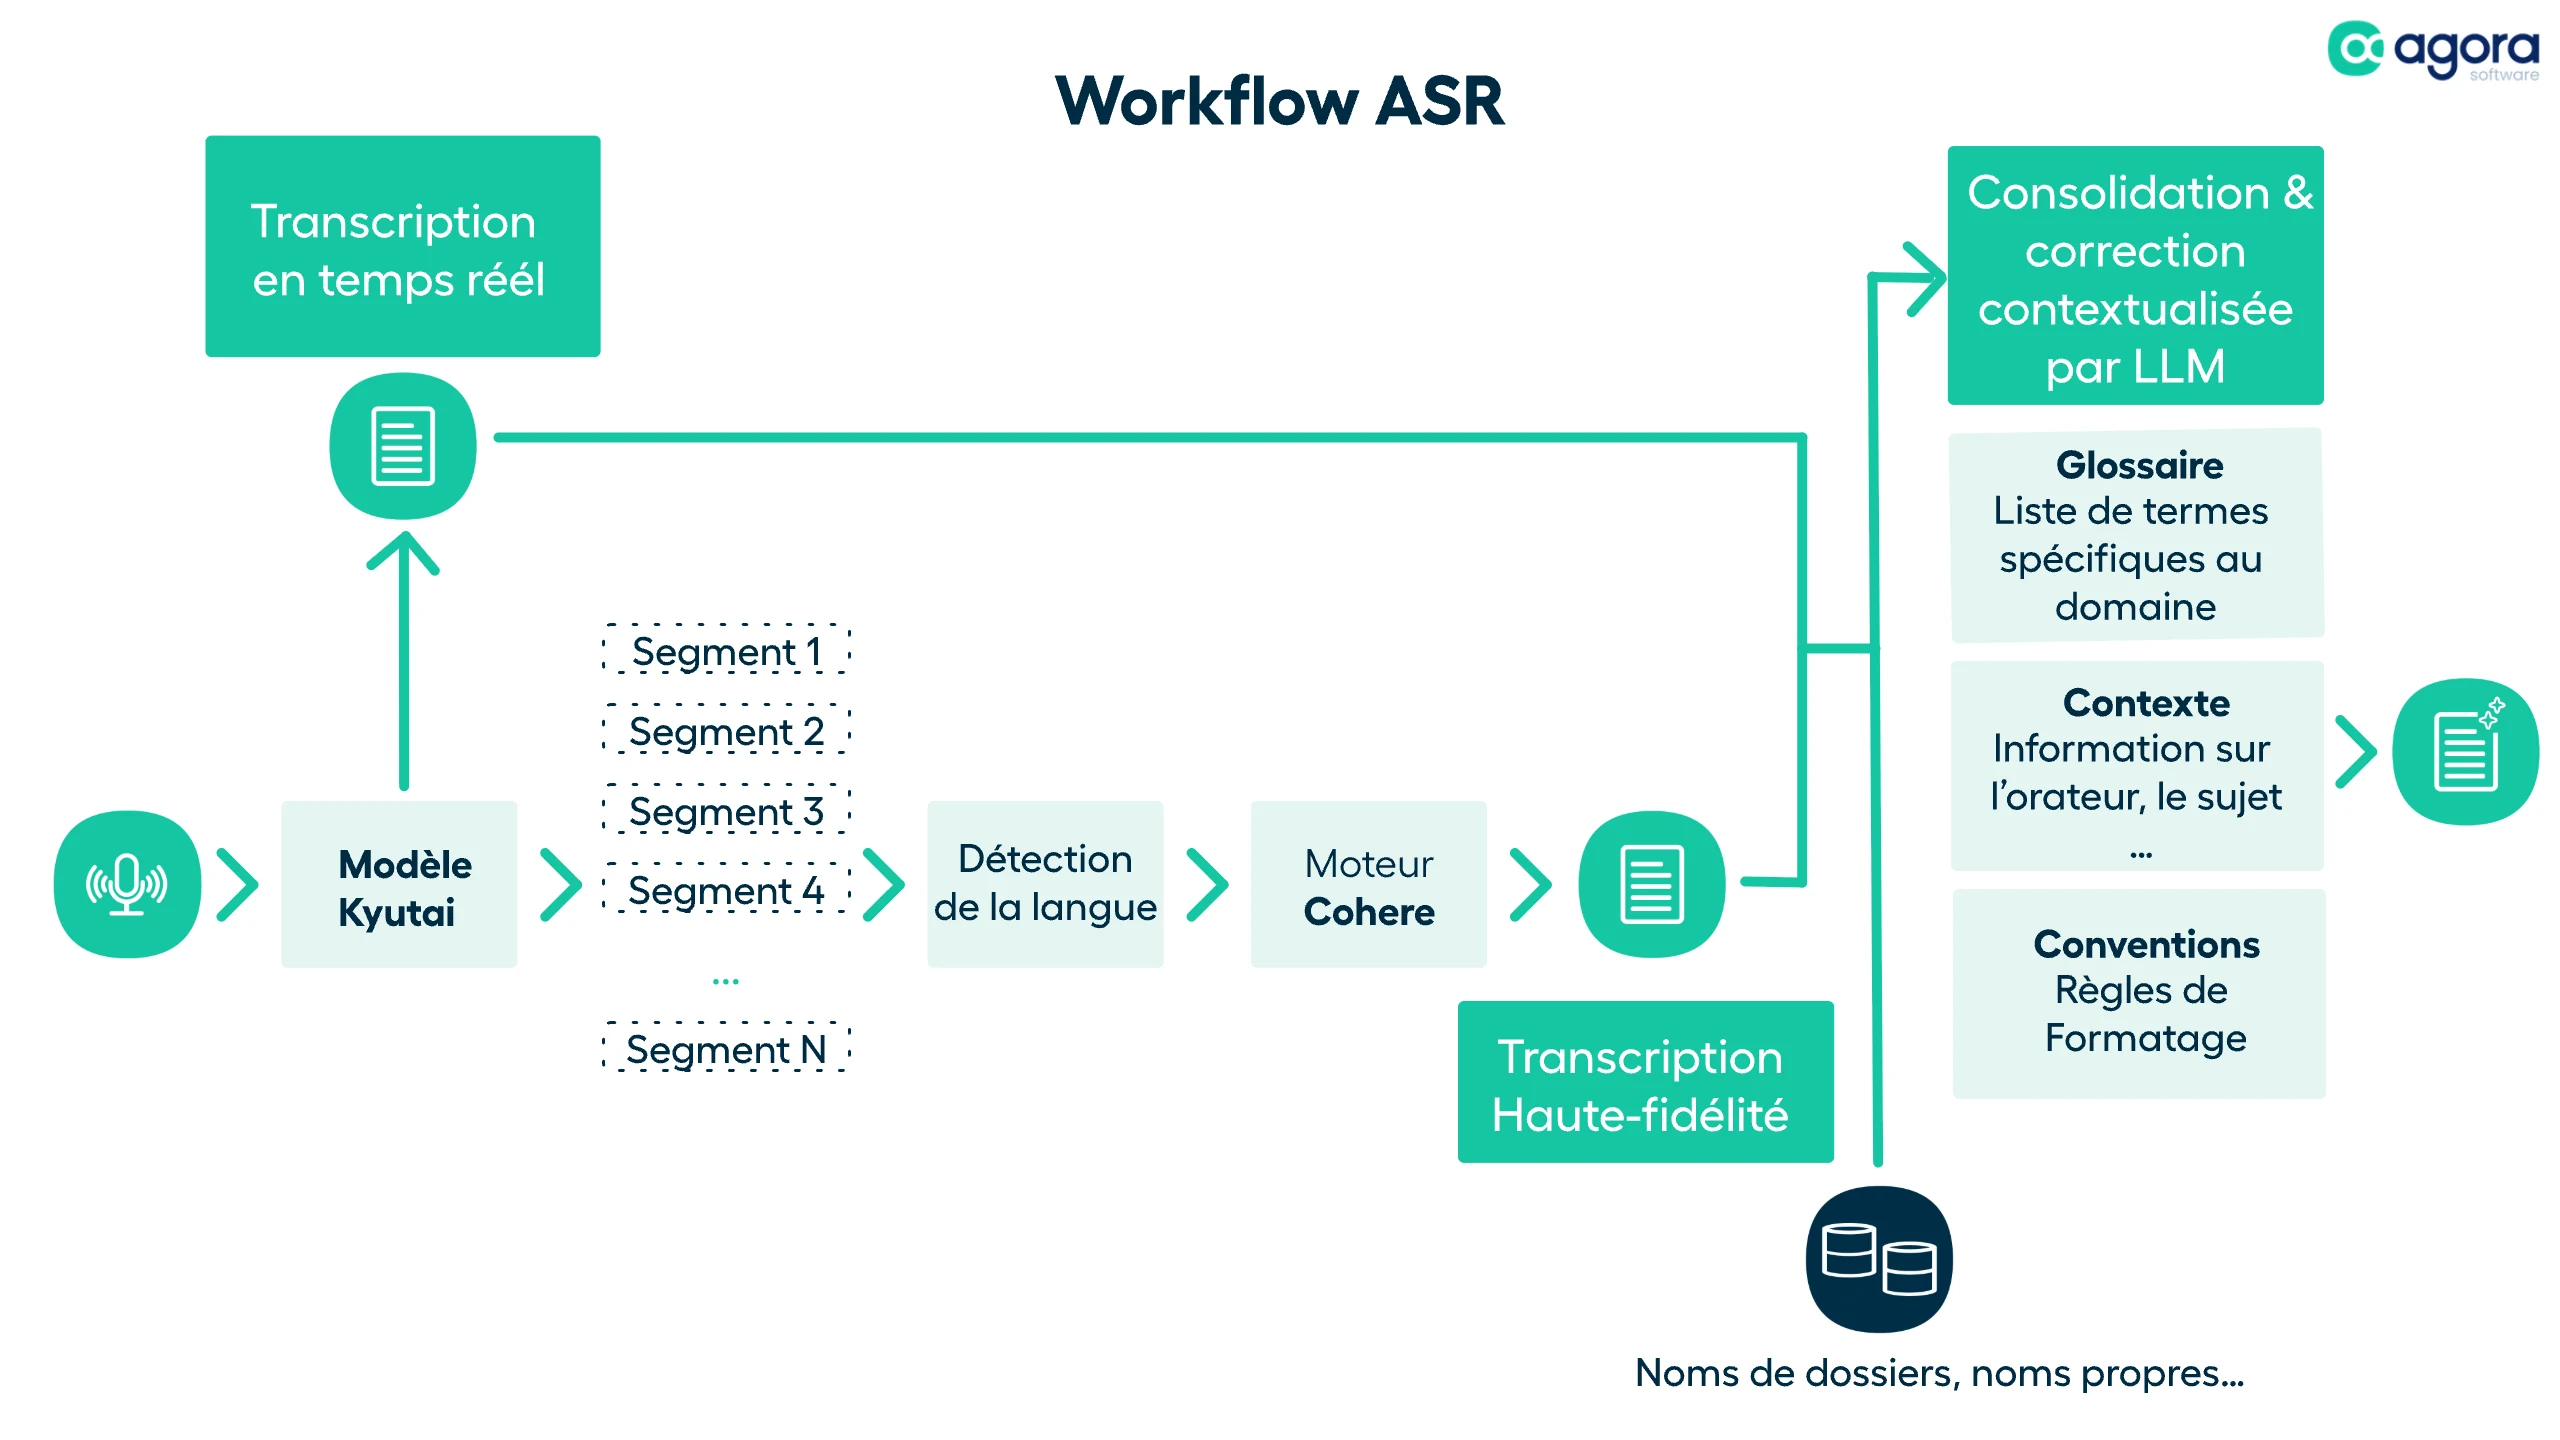
La transcription n'est qu'une étape. L'agent construit un workflow complet autour de la captation vocale (en temps réel ou en différé) et peut faire intervenir un LLM pour enrichir le résultat.
Transcription multi-modèle
Un workflow peut mobiliser deux modèles ASR en séquence ou en parallèle, chacun plus précis sur certains aspects, pour combiner leurs forces dans un même pipeline.
Contextualisation
Noms propres, codes produit, poste de l'utilisateur, sujets traités, glossaire métier, contexte de l'utilisateur : des informations contextuelles qui améliorent la précision et la qualité du résultat.
Post-traitement LLM
Un LLM intervient dans le workflow pour corriger la transcription (fautes, typos, formatage), la structurer, en extraire ou intégrer des entités ou générer un compte-rendu.
API WebSocket temps réel
Streaming audio bidirectionnel via WebSocket. Intégration simple dans n'importe quelle application web ou mobile.
 WebSocket API • Streaming temps réel • Multi-sessions
Détection automatique de langue
L'utilisateur parle dans sa langue. Le système détecte automatiquement laquelle et bascule de modèle de manière transparente, sans configuration côté utilisateur.
La transcription IA dans votre logiciel, pour quoi faire ?
Rapports terrain
Un technicien dicte son rapport d'intervention sans lâcher ses outils, et le logiciel remplit la fiche.
Compte rendu de réunion automatique
Réunions, entretiens, consultations : l'enregistrement est transcrit, puis structuré en compte rendu par un LLM.
Commande vocale
L'utilisateur demande à voix haute ce qu'il cherche, et l'agent interroge le logiciel pour lui répondre.
Appels et messages vocaux
Les appels sont transcrits pour en extraire les demandes, les motifs récurrents et les suites à donner.
Questions fréquentes sur la transcription IA
Quelle différence entre reconnaissance vocale, transcription IA et speech-to-text ?
Les trois désignent la même technologie : convertir la parole en texte. « Reconnaissance vocale » couvre plus largement les systèmes qui réagissent à la voix, y compris pour des commandes, « transcription IA » met l'accent sur le texte obtenu, et « speech-to-text » (ou « voice-to-text ») est le terme courant chez les développeurs. Agora couvre les trois usages : dictée, transcription d'enregistrements et commande vocale.
Qu'apporte Agora de plus qu'une API de transcription ?
Une API de transcription convertit l'audio en texte brut. Agora construit un workflow autour : la transcription tient compte de votre vocabulaire métier, un LLM corrige et structure le résultat, et un agent en fait quelque chose dans votre logiciel, comme remplir une fiche, rédiger un compte rendu ou alerter une équipe.
Existe-t-il une alternative à l'API Whisper hébergée en France ?
Oui. Agora est une alternative souveraine à l'API Whisper : la plateforme est hébergée en France, multi-modèle ASR, et votre audio ne part chez aucun fournisseur externe. Nous évaluons en continu les modèles de speech-to-text et retenons celui qui convient à votre langue et à votre usage.
Peut-on générer automatiquement un compte rendu de réunion ?
Oui. L'enregistrement est transcrit, puis un LLM le structure en compte rendu : points abordés, décisions, actions à suivre. Le format s'adapte à votre logiciel et à vos modèles de document.
Transcription en temps réel ou en différé : que choisir ?
Le temps réel convient quand l'utilisateur attend une réaction immédiate : dictée, commande vocale, sous-titrage. Le différé convient aux enregistrements longs (réunions, entretiens, appels), quand la précision compte plus que la latence. La plateforme propose les deux, et un même workflow peut les combiner.
Quelles langues sont prises en charge ?
Les principales langues européennes et asiatiques, dont le français, l'anglais, l'allemand, l'espagnol, l'italien, l'arabe, le japonais et le chinois. La langue est détectée automatiquement, sans réglage côté utilisateur.
Les enregistrements audio sont-ils conservés ?
Non. L'audio est traité puis supprimé, il n'est jamais stocké. La plateforme est hébergée en France, conforme au RGPD, sans fournisseur externe.
La voix dans votre logiciel ?
Discutons de l'intégration vocale dans votre application.