RAG : éviter les hallucinations LLM sur vos données métier
Le RAG (Retrieval-Augmented Generation) est devenu l’architecture de référence pour faire répondre une IA sur vos données : vos procédures, vos contrats, votre documentation produit, vos FAQ. Le principe tient en une phrase : on cherche dans vos documents, on transmet les passages pertinents au LLM, et le modèle rédige sa réponse à partir de ces passages.
C’est la bonne architecture. Elle ne fait pas disparaître les hallucinations pour autant : elle les déplace, et les rend plus difficiles à repérer. Une réponse inventée à partir de vos données emprunte votre ton, votre vocabulaire, parfois même la référence d’un passage qui n’existe pas.
Et il suffit d’une seule erreur qui circule (un paramètre appliqué à tort, une clause inventée, une procédure qui n’existe pas) pour que les utilisateurs perdent confiance dans toute la fonctionnalité.
Cet article s’appuie sur les projets RAG que nous menons avec des éditeurs de logiciels : d’où viennent les hallucinations, comment les mesurer avant et pendant la mise en production, et quels leviers actionner pour les limiter. Pour un tour d’horizon plus général de leurs causes et de leurs conséquences, lisez notre article sur les hallucinations des LLM.
Le RAG en 30 secondes
Deux étapes, deux composants :
- La recherche (retrieval) : la question de l’utilisateur est transformée en recherche dans votre index, c’est-à-dire vos documents découpés en passages et représentés sous forme de vecteurs sémantiques. Les passages les plus proches de la question sont sélectionnés.
- La génération : le LLM reçoit la question et les passages récupérés, et rédige une réponse.
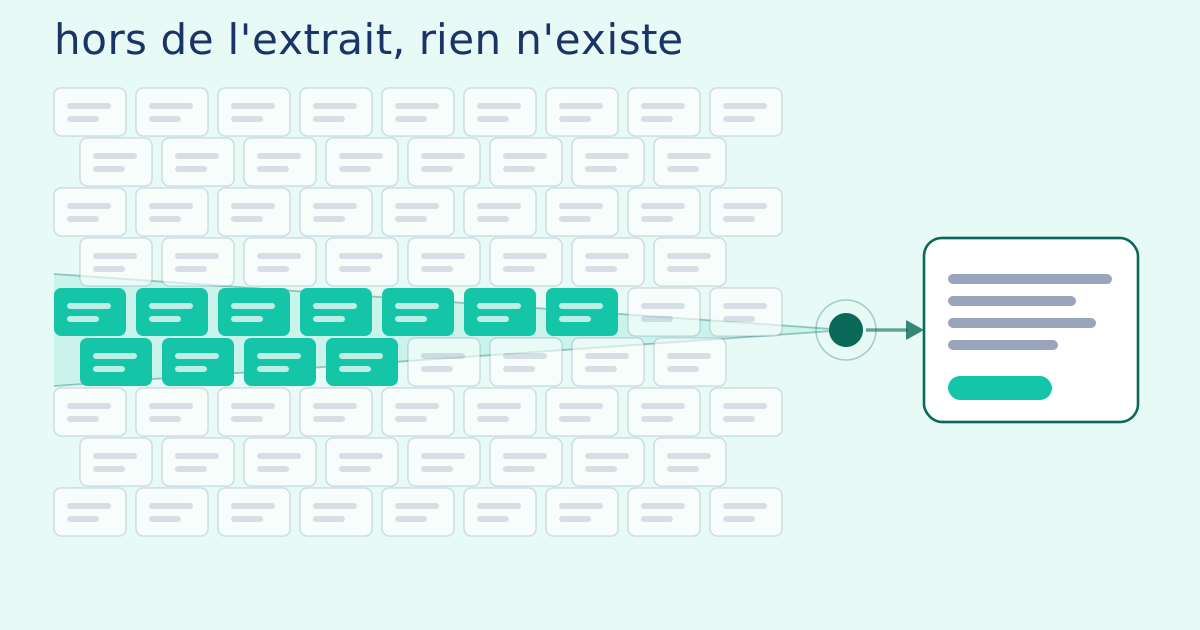
Le point essentiel : le LLM ne “consulte” pas votre base. Il lit un extrait sélectionné pour lui. Ce qui ne figure pas dans cet extrait, il l’ignore. C’est là que tout se joue.
Ce que nous observons sur le terrain
Sur nos projets, la plupart des hallucinations signalées ne venaient pas du modèle. Elles venaient de ce qu’on lui donnait à lire : un passage mal choisi par la recherche, des documents incomplets ou contradictoires, ou une question à laquelle même un expert humain n’aurait pas pu répondre sans demander une précision.
Ce constat change la façon de corriger. Face à une hallucination, le premier réflexe est souvent de changer de modèle ou de retoucher le prompt. La bonne première question est ailleurs : la bonne information était-elle dans le contexte, et sans ambiguïté ?
Trois origines, trois parades
1. La recherche n’a pas ramené la bonne information
Le passage pertinent n’a pas été récupéré : mauvais passage sélectionné, document jamais ingéré, ou tout simplement une réponse qui n’existe pas dans vos données, comme une décision récente que personne n’a encore documentée.
Il arrive aussi que la question elle-même soit trop imprécise. Une question comme “combien de jours j’ai droit ?” n’a pas de réponse fiable sans savoir de quel congé, de quel contrat ou de quelle convention il s’agit. Un collègue demanderait une précision.
Le LLM, lui, n’a pas de “je ne sais pas” par défaut. Il produit la suite la plus plausible, et il complète. C’est le cas le plus dangereux : la réponse inventée est rédigée dans le style de vos documents, elle a donc toutes les apparences d’une réponse officielle.
2. Les sources se contredisent
Chez un éditeur de logiciel RH que nous accompagnons, les réponses sur certains sujets variaient fortement d’une fois sur l’autre, et étaient parfois fausses. L’analyse a montré que le modèle n’était pas en cause : sur ces points précis, plusieurs documents de la base se contredisaient.
Faute de pouvoir trancher, le modèle faisait ce qu’il pouvait avec ce qu’il recevait, et produisait une réponse incohérente. Aucun réglage du prompt ou du modèle ne pouvait corriger un problème qui se trouvait dans les documents eux-mêmes.
L’analyse de ces hallucinations a mis en évidence un besoin précis : des agents dont le rôle est de s’assurer de la cohérence de la base documentaire, en repérant notamment les contradictions entre documents, pour qu’elles soient tranchées par un humain avant d’atteindre l’utilisateur.
3. La génération déforme une information pourtant présente
L’information est bien dans le contexte. Le modèle la paraphrase, confond deux passages, ou invente un détail : un numéro d’article, une date, un seuil, un nom. Sur les textes denses (juridique, finance, RH), c’est fréquent.
Pourquoi ? Un LLM est entraîné à produire le mot suivant le plus plausible, et la plausibilité n’est pas la fidélité. Rester fidèle à votre contexte n’est pas un objectif natif du modèle : c’est une contrainte qu’on lui impose, et qu’il faut vérifier.
Mesurer avant et pendant la production
Sans mesure, ce sont vos utilisateurs qui découvrent les hallucinations. Il est alors trop tard pour quantifier le problème, comparer des solutions ou vous engager sur des garanties contractuelles. Et la mesure ne s’arrête pas au lancement : elle se poursuit en continu tant que l’agent est en service.
1. Un jeu de test fondé sur la réalité
Notre recommandation : partir de la réalité des usages plutôt que de questions idéales. Un bon jeu de test combine deux familles de questions.
- Un socle de questions de contrôle, presque identique d’un projet RAG à l’autre, qui vérifie que les limites sont respectées. Quand l’information n’existe pas dans la base, l’agent doit répondre “je ne sais pas, car cette information ne figure pas dans ma base documentaire” au lieu d’inventer.
- De vraies requêtes d’utilisateurs, telles qu’elles sont réellement écrites : avec des fautes, des imprécisions, du jargon métier. Vos tickets de support et vos historiques de questions sont la meilleure source. C’est là que l’écart entre la démo et la production apparaît.
Chacun de ces cas appelle sa propre solution technique : une faute de frappe, une question trop vague et un terme de jargon ne se traitent pas de la même façon. Un RAG testé uniquement sur des questions propres et bien formulées ne vous apprend rien sur son comportement réel.
2. Les métriques à suivre
Le framework open source Ragas propose des métriques devenues courantes pour évaluer un RAG. Nous y ajoutons une mesure qui n’en fait pas partie, et qui est pour nous la plus importante.
- Précision et rappel du contexte (Ragas) : la recherche a-t-elle ramené les bons passages, et tous ceux qui étaient nécessaires ? Ces métriques évaluent la recherche.
- Fidélité (Ragas, faithfulness) : chaque affirmation de la réponse est-elle soutenue par le contexte récupéré ? Elle évalue la génération.
- Pertinence de la réponse (Ragas, response relevancy) : la réponse traite-t-elle bien la question posée ?
- Taux de refus : sur les questions de contrôle sans réponse dans la base, l’agent a-t-il refusé ou inventé ?
3. Comment les calculer
- LLM-as-judge : un LLM, souvent plus performant que celui évalué, note chaque réponse au regard du contexte, de façon automatique et reproductible. C’est ce qui permet de rejouer le jeu de test aussi souvent que nécessaire.
- Relecture humaine : relisez manuellement 10 à 20 % des cas, en priorité les refus et les cas limites. C’est votre référence.
- À chaque changement : rejouez le jeu de test dès que vous modifiez le découpage, l’index, le modèle ou le prompt. La comparaison avant/après rend chaque amélioration mesurable.
4. En continu, une fois en production
- Les feedbacks utilisateurs : une réponse signalée comme erronée est le point de départ le plus précieux pour remonter à la source d’une hallucination. En la rejouant avec son contexte, on identifie si le problème vient de la recherche, des documents ou de la génération.
- Le taux de réponses sans source citée : si chaque réponse doit citer ses sources, toute réponse sans source signale un dysfonctionnement à analyser.
- Des audits réguliers sur un échantillon de vraies conversations.
Ces feedbacks ont un second intérêt : ils enrichissent le jeu de test. Chaque requête signalée (formulation inattendue, question mal traitée, nouveau sujet) rejoint les vraies requêtes d’utilisateurs du jeu de test, qui colle ainsi de plus en plus à la réalité des usages.
Au final, l’objectif ne se résume pas à un pourcentage : c’est zéro erreur critique, c’est-à-dire aucune erreur qui conduise à une mauvaise action (un paiement, un contrat, une décision RH). C’est un objectif de conception autant que de mesure.
Les leviers pour limiter les hallucinations
1. Fiabiliser la base documentaire
C’est la leçon de notre projet RH : la qualité des réponses ne dépasse jamais celle des documents. Contradictions, versions qui coexistent, documents obsolètes : avant d’optimiser la chaîne, assurez-vous que la base dit une seule chose sur chaque sujet. Des agents de contrôle peuvent faire ce travail en continu et signaler les incohérences à un responsable métier.
2. Donner du sens à chaque passage indexé
La recherche repose sur la proximité vectorielle : elle rapproche la question des passages dont le sens est le plus proche. Or un passage isolé de son document perd souvent ce sens. “Ce délai est porté à 15 jours” ne dit ni de quel délai il s’agit, ni dans quel cas il s’applique.
Une grande partie de notre travail consiste à faire porter un maximum de sens à chaque contenu vectorisé, notamment en enrichissant chaque passage du contexte qui l’entoure (document, section, sujet traité) avant de l’indexer. S’y ajoutent :
- Un découpage qui respecte la structure : une clause ne doit pas être coupée en deux, un tableau doit rester entier. On découpe selon la structure du document, pas selon un nombre de caractères.
- Des métadonnées métier : type de document, version, date d’effet, périmètre. La recherche peut alors filtrer.
- Une recherche hybride : la recherche sémantique seule peine sur les questions à mots-clés (numéros de procédure, références de clause). Combiner recherche lexicale et sémantique couvre les deux cas.
- Un reclassement (reranking) : la recherche initiale ramène du bruit. Un reclassement sélectionne les quelques passages qui comptent vraiment.
3. Contraindre la génération
Ici, le prompt est un contrat, pas une suggestion :
- “Réponds uniquement à partir du contexte fourni.”
- “Si la réponse n’est pas dans le contexte, dis-le. N’invente pas.”
- Cite les passages utilisés.
Et le point de vue qui change tout : savoir refuser est une fonctionnalité. Une IA qui répond “je n’ai pas cette information dans nos documents, voici où chercher” gagne la confiance de ses utilisateurs : ils savent que lorsqu’elle répond, sa réponse est fondée.
4. Citer les sources
Chaque réponse doit pointer vers le passage exact qui la soutient. C’est bien plus qu’un détail d’ergonomie :
- L’utilisateur vérifie en quelques secondes. La confiance se construit sur ce qui est vérifiable.
- Votre support retrouve en une minute l’origine d’une réponse contestée.
- Une réponse sans source est une réponse que personne ne peut vérifier.
C’est le principe de notre fonction Chercher : chaque réponse est sourcée, et la chaîne vérifie sa fidélité aux documents avant de la renvoyer.
5. Encadrer le périmètre critique
- Sur les actions sensibles (RH, contrat, paiement) : validation humaine avant l’action. Le modèle n’agit jamais seul.
- Traçabilité complète : question, contexte récupéré, réponse, modèle et version. Chaque réponse est auditable et reproductible.
- Surveillance : d’après notre expérience, une baisse de fidélité signale le plus souvent un problème de documents (mal mis à jour, mal ingérés, contradictoires) plutôt qu’un problème d’IA. L’alerte doit vous orienter vers vos données.
Et une IA sans vos données ?
Un LLM sans RAG ne connaît ni vos règles, ni vos versions, ni votre historique. Sur vos questions, il répond avec la moyenne de ce qu’il a vu pendant son entraînement, et cette moyenne ne correspond pas à votre réalité.
Le RAG change la nature de l’erreur : on passe d’une réponse plausible et générique à une réponse sourcée et vérifiable. C’est la différence entre une fonctionnalité IA qu’on montre en démo et une fonctionnalité qu’on peut inscrire dans un contrat.
Ce qu’il faut retenir
- Sur le terrain, la plupart des hallucinations viennent de ce que le modèle reçoit : passage mal choisi, documents contradictoires, question trop imprécise. Identifiez l’origine avant de toucher au modèle.
- Mesurez avant et pendant la production, avec un jeu de test fondé sur la réalité : questions de contrôle des limites et vraies requêtes d’utilisateurs, fautes et jargon compris. Rejouez-le à chaque changement, et enrichissez-le avec les requêtes repérées en production.
- Limitez les hallucinations en commençant par les données : base documentaire cohérente, passages enrichis de leur contexte, recherche hybride, reclassement.
- Savoir refuser est une fonctionnalité, citer ses sources est une architecture, et le périmètre critique reste validé par un humain.
La qualité d'un RAG se joue surtout dans la recherche et dans les documents. Sur la page Chercher, découvrez comment Agora construit une recherche documentaire où chaque réponse est sourcée et vérifiée.
Intégrez l'IA dans votre logiciel avec Agora Software.
Parlons-en