Micro-décisions IA : réduire le coût et la latence des LLM
En résumé
- Une grande partie du travail d’un logiciel ou d’un agent IA tient en micro-décisions : ce ticket est-il urgent, à quelle équipe l’affecter, ce document est-il une facture ?
- Confiées à un grand modèle de langage (LLM) généraliste, elles coûtent cher à grand volume, prennent des secondes et renvoient du texte libre qu’il faut interpréter.
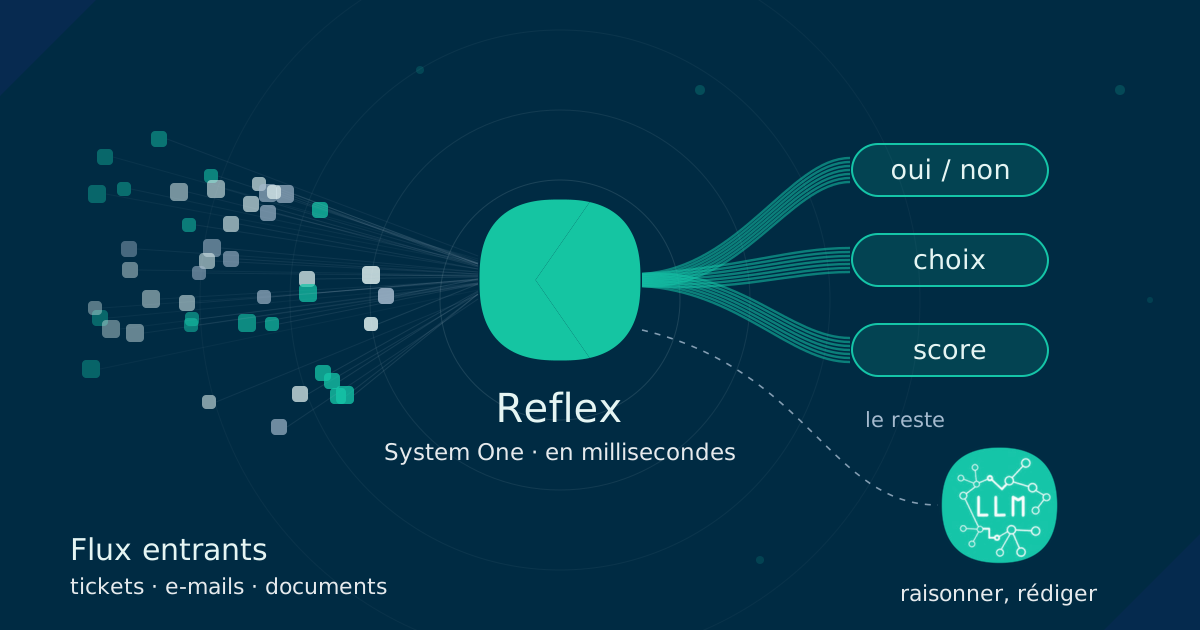
- Un moteur de décision dédié, de type “System One”, répond à ces questions en quelques centaines de millisecondes, avec une réponse typée et sa probabilité. Le LLM reste disponible pour ce qui demande de rédiger ou de raisonner.
Gartner prévoit qu’au moins 15 % des décisions du travail quotidien seront prises de façon autonome par l’IA agentique d’ici 2028, contre zéro en 2024. Dans le même communiqué, le cabinet annonce que plus de 40 % des projets d’IA agentique seront abandonnés d’ici fin 2027, d’abord à cause de coûts qui dérapent.
Ces deux chiffres parlent du même sujet. La plupart des décisions qu’un agent prend dans une journée sont courtes et répétées : ranger un courrier, fixer un niveau d’urgence, valider une étape avant d’agir. Les confier toutes à un LLM généraliste, c’est payer le prix d’un raisonnement pour des questions qui attendent un simple oui ou non.
Qu’est-ce qu’une micro-décision ?
Certaines conditions s’écrivent en une ligne de code : un montant au-dessus d’un seuil, une date dépassée, un champ vide. D’autres demandent de lire un texte ou une image pour trancher, et chaque logiciel métier a les siennes :
- CRM : cet e-mail d’un client annonce-t-il une résiliation ?
- ERP : cette réclamation porte-t-elle sur un retard, un produit défectueux ou une erreur de facturation ?
- SCM et logistique : ce bon de livraison scanné porte-t-il une réserve manuscrite du destinataire ?
- SIRH : cette question d’un salarié relève-t-elle de la paie, des congés ou de la mutuelle ?
- Recrutement : cette candidature correspond-elle au poste, sur une échelle de 1 à 4 ?
- Expertise comptable : cette pièce est-elle une facture d’achat, une note de frais ou un avoir ?
- Juridique : ce contrat contient-il une clause de non-concurrence ?
- Maintenance et SAV : cette photo prise sur le terrain montre-t-elle une fuite ?
Une micro-décision a trois traits :
- Une question fermée sur un contenu, texte ou image.
- Une réponse d’un type connu à l’avance : oui ou non, un choix dans une liste que vous définissez, ou un score sur une échelle.
- Un volume élevé : des milliers à des millions par jour, tous clients confondus.
Dans une application agentique, elles s’ajoutent à chaque étape : l’agent doit décider quel outil appeler, si la demande sort de son périmètre, si l’action qu’il prépare présente un risque.
Ce que coûte une micro-décision confiée à un LLM
Un LLM généraliste sait répondre à ces questions. Le problème tient à la façon dont il le fait, multipliée par le volume.
La facture suit le volume. Chaque appel facture les tokens envoyés (les instructions, le contenu à analyser, souvent des exemples) et les tokens générés. Une décision isolée coûte peu. Un million de décisions par mois, réparties sur tous vos clients, finissent par peser sur la marge du produit, et ce coût augmente avec le succès de la fonctionnalité.
La latence s’additionne. Un LLM génère sa réponse token après token. Pour une question simple, cela prend couramment une à plusieurs secondes. Dans un agent qui enchaîne cinq ou six décisions avant d’agir, ces secondes s’empilent, et l’utilisateur attend.
La réponse est du texte libre. Même avec une consigne stricte, le modèle peut ajouter une phrase d’explication, changer la casse d’une catégorie ou inventer une catégorie proche de celles demandées. Votre code doit interpréter la réponse, et chaque écart devient un cas d’erreur à gérer.
Le débit dépend d’un tiers. Les API de LLM appliquent des quotas de requêtes par minute. Un pic d’activité chez vos clients peut buter sur une limite que vous ne maîtrisez pas, un sujet développé dans notre article sur la dépendance à une API de LLM.
Système 1, système 2 : répartir les décisions
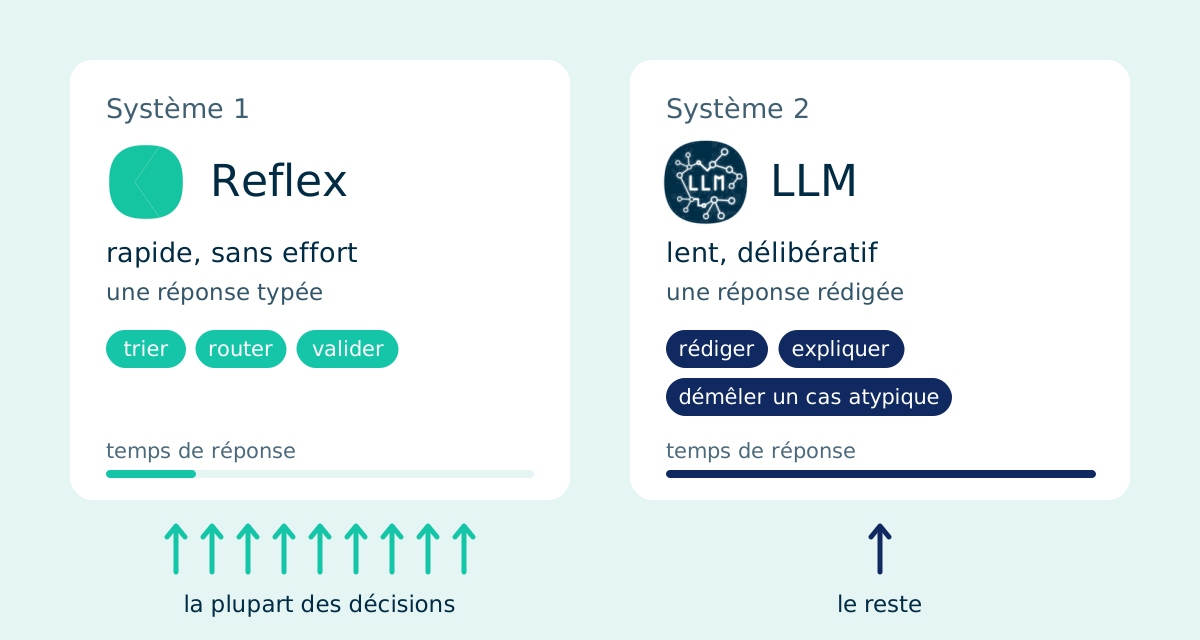
Le psychologue Daniel Kahneman, prix Nobel d’économie, distingue deux modes de pensée dans Système 1 / Système 2. Les deux vitesses de la pensée (2011) : un système rapide et intuitif, qui répond sans effort, et un système lent et délibératif, mobilisé quand la question l’exige. Un humain passe l’essentiel de sa journée en système 1 et réserve le système 2 aux problèmes qui le méritent.
Appliquée aux logiciels, l’idée consiste à confier chaque décision au modèle qui lui convient. La recherche a déjà mesuré l’intérêt de cette répartition. Les auteurs de FrugalGPT (Stanford, 2023) obtiennent les performances du meilleur LLM testé avec une réduction de coût allant jusqu’à 98 %, en envoyant chaque requête au modèle le moins cher capable d’y répondre. L’équipe de RouteLLM (2024) montre qu’un routeur entre un modèle puissant et un modèle léger divise les coûts par plus de deux dans certains cas, sans baisse de la qualité des réponses.
Un moteur de décision System One pousse cette logique plus loin : au lieu d’un modèle plus petit qui génère toujours du texte, un modèle conçu pour décider. Il reçoit le contenu et les questions, et renvoie en un seul passage une réponse typée par question, avec sa probabilité. Il ne rédige rien, et c’est précisément ce qui le rend rapide.
Ce que nous avons observé en testant Reflex
Reflex est le moteur de décision System One d’Agora. Nous l’avons testé le 10 novembre 2026 sur la démo publique de Reflex, dans les conditions qu’un visiteur rencontre.
Sur six documents d’exemple (une facture, un contrat signé, un relevé de compte, un bulletin de paie, un ticket de restaurant et la photo floue d’un courrier), Reflex a répondu à trois questions par document : le type de document, la présence d’une signature manuscrite et la lisibilité. Les six documents ont été traités en 0,75 seconde au total, appels en parallèle. Les cinq documents lisibles ont été classés correctement avec une probabilité de 99 à 100 %, et la signature du contrat repérée à 100 %.
La photo floue est le cas le plus instructif. Reflex l’a classée “Autre” avec une probabilité de 30 %, et jugée illisible. C’est exactement le rôle de la probabilité : sous un seuil que vous fixez, la décision remonte à un humain au lieu d’être appliquée. Le moteur range seul ce qui est clair et signale ce qui ne l’est pas.
Sur des tickets de support, le résultat est du même ordre : “Serveur de production hors service, plus aucune facture ne sort depuis 9 h” a été classé incident à 99,98 %, utilisateur bloqué à 99,5 %. Une demande d’évolution du tableau de bord a été reconnue comme telle à 99,95 %, sans caractère bloquant.
Comment répartir les décisions dans votre logiciel
Trois étapes suffisent pour savoir ce qu’un moteur de décision peut prendre en charge chez vous.
- Repérer les appels à un LLM qui attendent une réponse fermée. Chaque prompt qui se termine par “réponds uniquement par oui ou non” ou “choisis parmi ces catégories” est une micro-décision.
- Écrire les questions et les listes de choix en langage naturel. Avec Reflex, elles sont transmises dans chaque requête : aucun entraînement préalable, et vous adaptez les catégories à la taxonomie de chaque client.
- Fixer un seuil de probabilité. Au-dessus, la décision s’applique. En dessous, elle remonte à un humain, comme dans nos cas d’usage de classement automatique des courriers entrants ou de priorisation des demandes par niveau d’urgence.
Le LLM garde tout ce qui demande de rédiger, d’expliquer ou de démêler un cas atypique. Il reçoit moins d’appels, et ceux qu’il reçoit sont ceux qui justifient son coût.
Reste la question du modèle économique. Facturée au token, une décision coûte un peu à chaque appel, et la facture suit le volume. Reflex est proposé en licence à la capacité : vous souscrivez un débit de pointe en décisions par seconde, le coût mensuel est fixe quel que soit le nombre de décisions, et les données sont traitées en France, un point qui compte pour les éditeurs dont les clients exigent une IA souveraine.
Les signes qu’une décision mérite un moteur dédié
- Votre facture LLM augmente alors que la plupart des appels servent à trier, router ou valider.
- Vos volumes se comptent en milliers par jour, ou le seront quand la fonctionnalité sera adoptée par tous vos clients.
- La décision doit tomber en temps réel, pendant que l’utilisateur attend.
- Votre code parse des réponses en texte libre et gère des cas d’erreur quand le modèle sort du format.
- Vos clients sont sous NDA ou dans un secteur réglementé et exigent un hébergement en France.
Quand plusieurs de ces signes sont réunis, le plus simple est de tester sur vos propres contenus : la démo Reflex accepte vos textes, vos images et même un dossier entier, et compare son classement à votre rangement.
Reflex prend les micro-décisions de votre logiciel et de vos agents en quelques centaines de millisecondes, et laisse au LLM ce qui demande de raisonner. Testez-le en direct sur vos contenus, ou montrez-nous un cas réel.
Intégrez l'IA dans votre logiciel avec Agora Software.
Parlons-en